
开源 LLM 评测和 Prompt 回归测试工具,适合比较模型、提示词和安全策略。
4.8/ 5编辑评分
96/100推荐指数
可信度 A80/100
1,200 站内热度
2.8 万 次浏览
prompt testingopen sourceevaluation
快速判断推荐指数 96/100可信度 A核验 2026-09-10
适合谁
- 评估维度可自定义,覆盖常见测试需求
- 支持自动化批量运行
不适合谁 / 注意
- 需要完全离线或强私有化部署但官网未提供对应方案的场景
- 不能接受人工复核、授权核验或结果校验的高风险任务
promptfoo 是什么?
promptfoo 是开源的 LLM 应用测试与评估工具,支持提示词回归测试、模型对比、质量评估和 CI 集成,是 AI 应用质量保障的常用工具。
promptfoo 的核心价值是「AI 测试自动化」:把提示词和模型输出变成可测试的用例,自动运行、对比和打分,防止提示词修改导致质量回退,适合 AI 工程团队。
需要客观看待的是:需要测试工程能力,评估标准需自行设计,模型调用按量计费。
百器AI 将 promptfoo 归入「AI 评估」分类,适合 AI 应用开发团队和质量工程师。
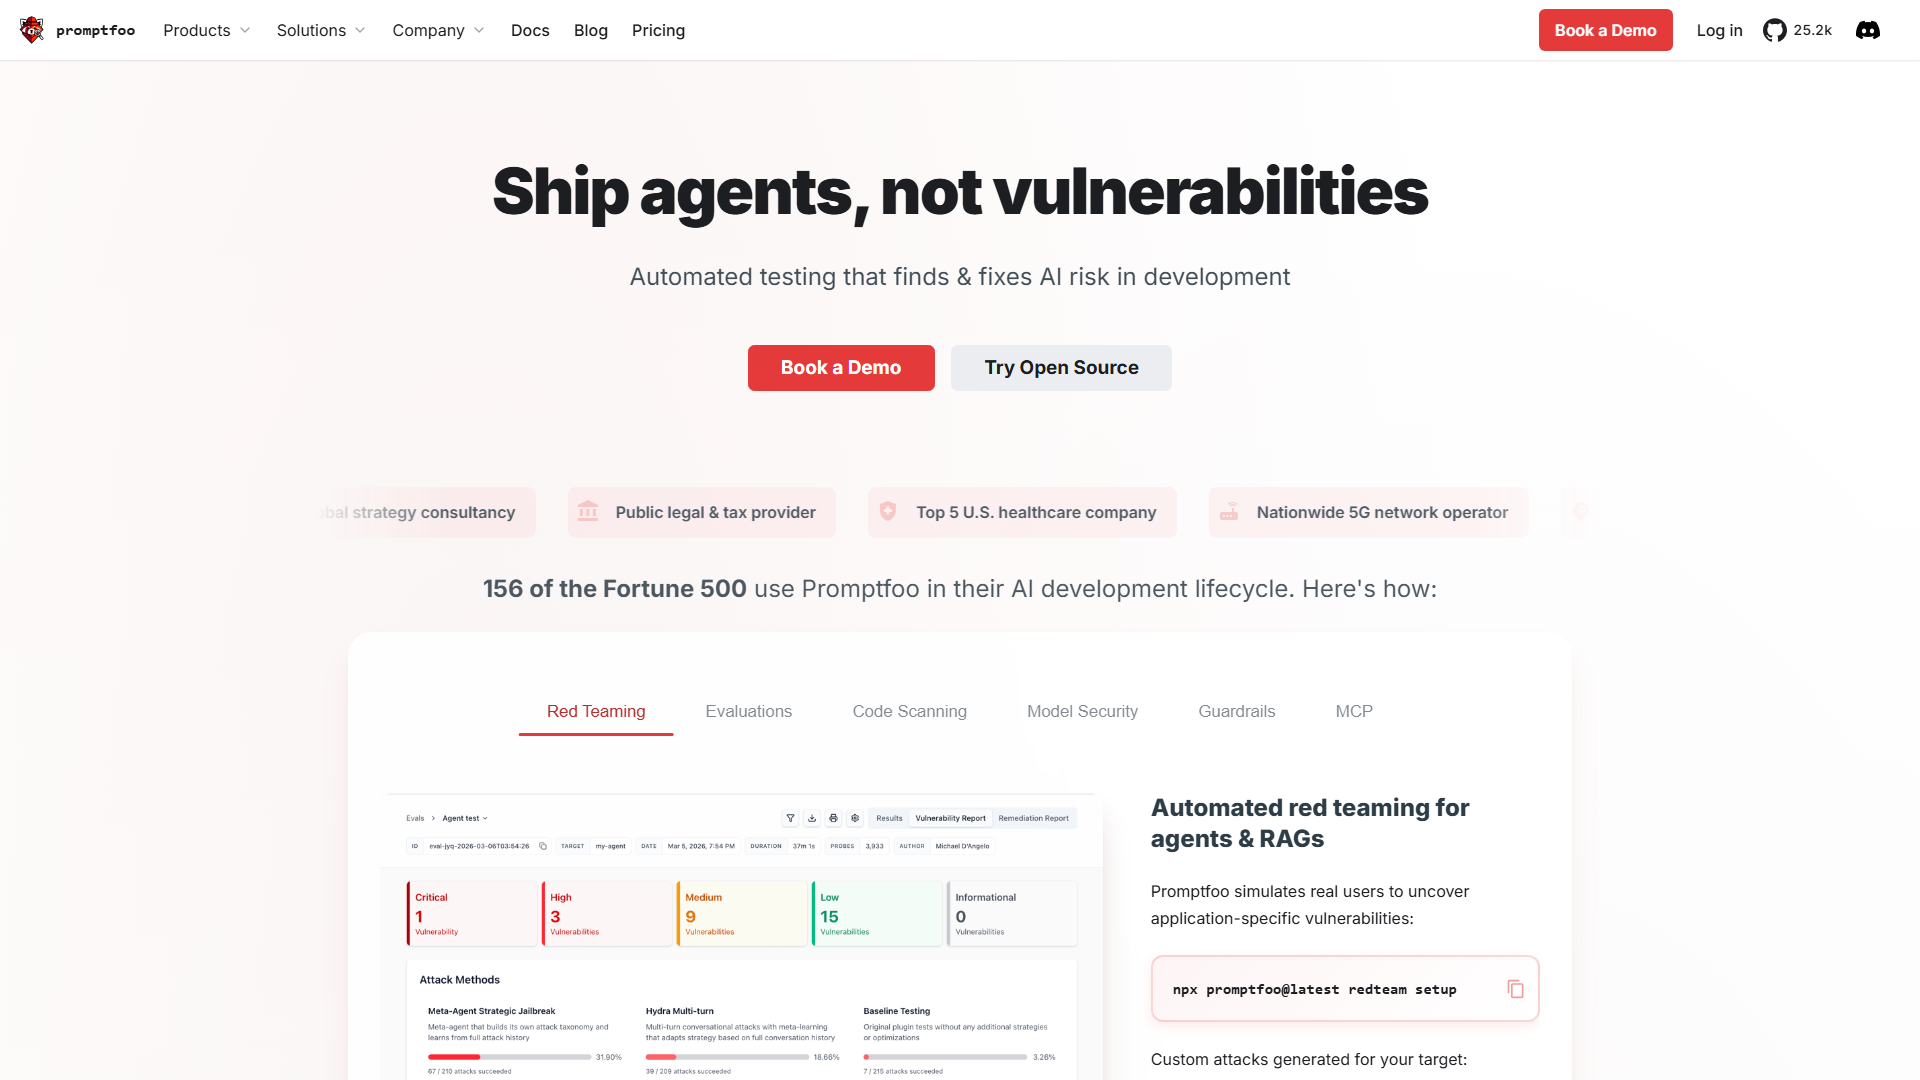
产品截图
主要功能
1
提示词测试:回归测试和防回退
2
模型对比:多模型效果对照
3
质量评估:自动打分和断言
4
CI 集成:测试嵌入开发流程
5
可视化报告:测试结果展示
6
开源免费:MIT 协议
如何使用
1
定义评估维度与测试集后批量运行,结合人工抽检确认结果
2
先跑通小样本全流程再扩大测试集
3
记录每次评估的模型版本与参数,保证可比性
4
评估口径与业务指标对齐,避免分数与体感脱节
5
定期回归防止能力回退
核心优势
评估维度可自定义,覆盖常见测试需求
支持自动化批量运行
报告可视化便于团队共享
同类竞品对比
| 对比维度 | promptfoo | Ragas | LM Evaluation Harness |
|---|---|---|---|
| 核心能力 | 提示词测试:回归测试和防回退;模型对比:多模型效果对照 | 忠实度评估:答案是否忠于上下文;相关性评估:答案和问题匹配度 | 标准基准:MMLU、GSM8K 等;模型对比:多模型统一评估 |
| 上手门槛 | 免费版可体验,进阶功能按订阅收费 | 免费使用,注册即可体验 | 免费使用,注册即可体验 |
| 适合场景 | 选择适合业务的大模型 | 选择适合业务的大模型(支持 Web、API、开源项目) | 选择适合业务的大模型(提供中文支持) |
| 独特优势 | 能减少凭感觉选型 | 能减少凭感觉选型(支持 Web、API、开源项目) | 能减少凭感觉选型(提供中文支持) |
| 注意事项 | 需要维护测试集和指标 | 需要维护测试集和指标(支持 Web、API、开源项目) | 需要维护测试集和指标(提供中文支持) |
应用场景
模型能力基准测试
回归测试与质量评估
A/B 对比实验
上线前质量门禁
数据集构建与标注管理
标签
prompt testingopen sourceevaluation
注意点
自动评估分数不能完全替代人工判断,需两者结合
测试集质量决定评估可信度
跨模型对比需注意口径一致
不适用边界
需要完全离线或强私有化部署但官网未提供对应方案的场景
不能接受人工复核、授权核验或结果校验的高风险任务
常见问题
开源免费,模型调用费用自理,云版按需付费。


